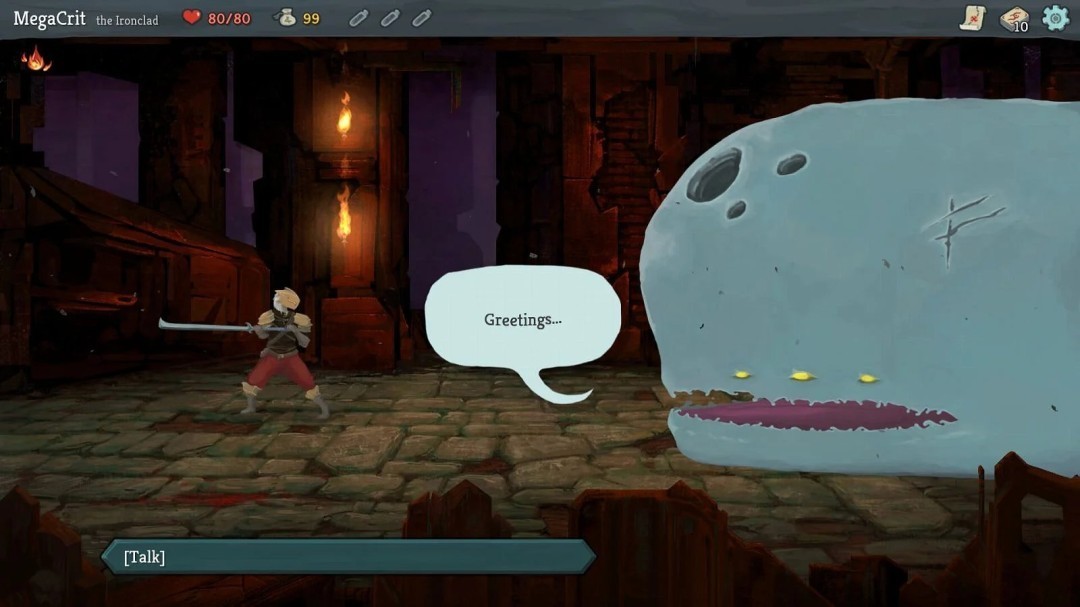
一项尚未经过同行评议的研究对二十种大型语言模型在杀戮尖塔最高难度进阶二十的挑战表现进行了系统性评估。实验共进行两百局游戏,所有模型均以铁甲战士角色出战,在统一设定的十个随机种子条件下,每种模型各完成十局。测试依托专用评估环境SpireBench展开,为避免模型因过往接触相关攻略而产生偏差,游戏中所有专有名称均被替换处理。
结果显示,仅GPT-5.6 Sol在全部两百局中成功击败最终首领一次。部分模型在首幕通关率上表现突出:GPT-6 Astra、Claude Fable 5.1与Claude Opus 5均实现十局中九局通过首幕,但后续关卡的推进能力迅速下滑,最终达成通关的局数极少。
研究将模型表现与约二十万六千局铁甲战士的真实对局数据,以及四名长期专注该游戏的资深玩家的实录进行横向比照。分析指出,当前表现较优的模型已具备基础战斗决策能力,包括实时伤害估算、能量管理及当回合卡牌使用,但在涉及长远资源规划的关键选择上,例如是否接受高风险精英战、是否牺牲短期收益换取长期强化,仍显著落后于人类高手。
行为模式分析进一步揭示差异:模型普遍回避精英遭遇战,在休息点恢复生命值的倾向强烈,且极少在战斗后主动弃牌。统计显示,模型平均每局抵达首幕首领前仅与精英交手一点二五次,而资深玩家该数值为二点六次;模型在可选休息点选择恢复生命的概率达百分之六十八,人类玩家则仅为百分之九。与此同时,模型抵达首幕首领时平均保有较高生命值,却常因此错失卡牌升级、遗物获取等关键成长机会。
研究还发现,重复游玩未带来可验证的性能提升。受限于每种模型仅完成十局测试,结果可能受随机性影响;此外,人类玩家所用随机种子与模型不一致,且本次实验仅覆盖铁甲战士单一角色。因此,现有数据尚不足以对模型与人类玩家的真实实力进行严谨排序。
文章来源:LLM在杀戮尖塔高难挑战中表现评估:决策短板显著,远逊人类高手https://news.zol.com.cn/1260/12602773.html